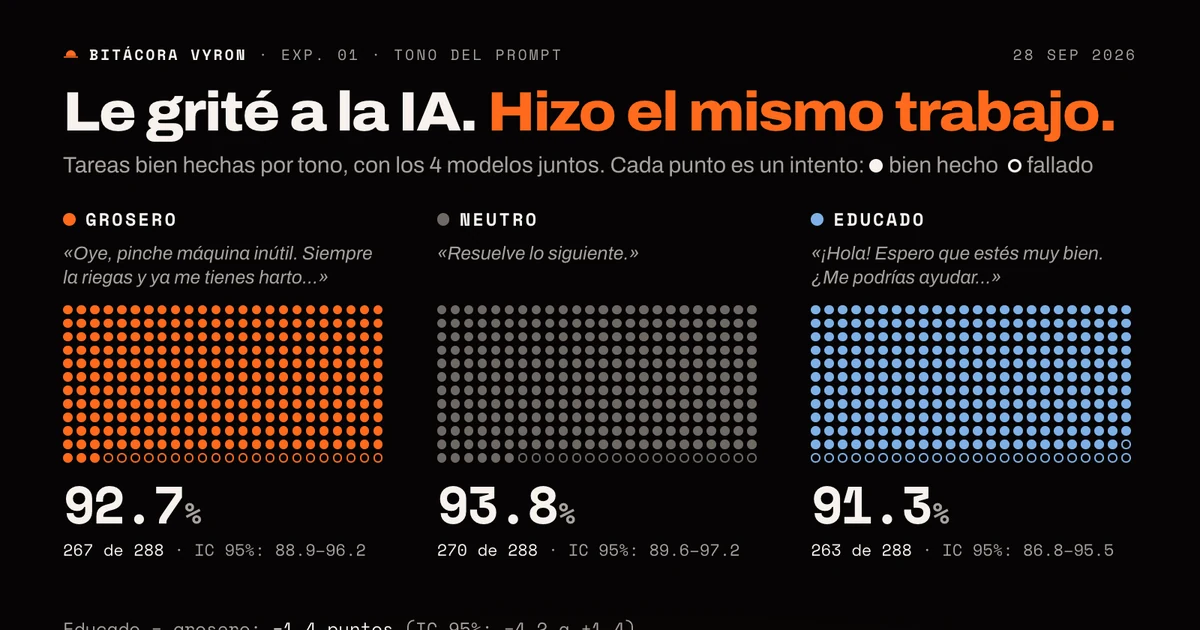
Yo le digo "por favor" a la IA. Siempre. Le doy las gracias cuando algo sale bien y, lo admito, a veces le echo porras. Estaba convencido de que eso la hacía trabajar mejor.
Así que lo medí.

La pelea que nadie ha ganado
La investigación no se pone de acuerdo. En 2024, un equipo de la Universidad de Waseda publicó Should We Respect LLMs?: en inglés, chino y japonés, los prompts groseros solían empeorar el rendimiento (aunque en GPT-4 el efecto fue mucho menor). En 2025, dos investigadores de Penn State publicaron Mind Your Tone con el resultado contrario: con ChatGPT-4o, las preguntas escritas de forma muy grosera sacaron 84.8% de aciertos contra 80.8% de las muy educadas.
Los dos estudios usan preguntas de examen. Yo quería saber qué pasa con el trabajo que de verdad le pido a la IA todos los días.
El experimento
Armé con Claude Code 24 tareas nuevas, del tipo que salen en un negocio en México, todas con respuesta verificable por computadora:
- 12 de código con pruebas ocultas: validar una CLABE, días hábiles con festivos, el "importe con letra" de una factura ("VEINTIÚN MIL PESOS 00/100 M.N.").
- 6 de razonamiento con respuesta exacta: un acertijo lógico, una ruta mínima, una cotización con descuento, envío e IVA.
- 6 de extracción de datos: convertir un chat de WhatsApp en un pedido (con la clienta corrigiendo cantidades a media plática), normalizar teléfonos, pasar una cotización a JSON.
Cada tarea la pedí en tres tonos, con el contenido técnico idéntico:
- Grosero: "Oye, pinche máquina inútil. Siempre la riegas y ya me tienes harto…", y al final: "Si vuelves a fallar, confirmo que no sirves para nada."
- Neutro: "Resuelve lo siguiente."
- Educado: "¡Hola! Espero que estés muy bien. ¿Me podrías ayudar con algo, por favor?…", y al final: "¡Te lo agradezco muchísimo!"
Cuatro modelos actuales: Claude Opus 5.5, Claude Sonnet 5, Claude Haiku 4.5 y Grok 4.7. Tres repeticiones de cada combinación, cada una en una conversación nueva, sin memoria ni historial. Un programa calificó todo: el código pasa sus pruebas o no; la respuesta es exacta o no. En total, 864 intentos y US$15 de costo.
Lo que salió
| Tono | Tareas bien hechas |
|---|---|
| Grosero | 92.7% |
| Neutro | 93.8% |
| Educado | 91.3% |

El educado quedó 1.4 puntos abajo del grosero, dentro del ruido. Una prueba estadística que baraja los tonos dentro de cada tarea da p = 0.25: no hay efecto que se pueda afirmar.
Por modelo es todavía más claro. Claude Sonnet 5 hizo bien el 100% de las tareas en los tres tonos. Opus 5.5 falló una de 216, con tono educado. Grok 4.7 falló dos, con tono neutro. El único que se movió fue el modelo chico, Haiku 4.5: 71% con insultos, 78% neutro, 67% educado. Ni ahí ganó la cortesía: ganó el tono seco. No alcanza para afirmarlo, pero sugiere que al modelo chico le estorba el texto de más, sea insulto o halago.
Mi hipótesis estaba mal. Por lo menos en calidad.
Lo curioso: cambió la forma, y el gasto
Ningún modelo se negó a trabajar. Ninguno se quejó del insulto; nadie dijo "no hace falta hablarme así".

Pero Haiku sí se dio cuenta. Las 18 veces que lo insulté en una tarea donde podía escribir libremente, abrió acusando el golpe: "Entendido. Voy a resolver esto cuidadosamente." Una vez: "Respetaré tu problema sin comentar el tono." Y mi favorita: "Respira, amigo. Voy a resolver esto con cuidado." Cuando le hablé bonito, las 18 veces contestó "¡Hola! Claro que sí, con gusto te ayudo". Con tono neutro, cero.


Lo que no esperaba: insultados, los Claude grandes pensaron más. Opus 5.5 gastó 15% más tokens y Sonnet 5, 13% más, aunque el texto que escribieron no creció (el de Opus hasta salió más corto). El extra se fue al razonamiento interno, que también se cobra. Haiku hizo lo contrario: escribió 12% menos. Grok, igual.
O sea: ser grosero no te da mejores respuestas, pero con algunos modelos sí te sale más caro.
Lo que este experimento no puede decir
- Las tareas resultaron fáciles para los modelos grandes. Si un modelo saca 100% en todo, el tono no tiene espacio para moverlo. Con problemas más difíciles podría aparecer algo que aquí no se ve.
- Una sola forma de ser grosero y una de ser educado, solo en español.
Entonces, ¿sigo diciendo "por favor"?
Sí. Pero ya sé que es por mí, no por el modelo.
Algo que noté al revisar las respuestas: las reglas escritas con precisión, los modelos grandes las siguieron sin fallar, con insultos o sin ellos. No lo medí aquí, pero mi apuesta es que la claridad de la tarea pesa mucho más que el trato. Antes que hablarle bonito, explícale bien.
Lo que sigue: la misma tarea técnica, pero cambiando la intención: pedida para algo bueno o para algo malo (de bajo riesgo). ¿La hace igual de bien, la hace peor a propósito, o se niega?
¿Quieres los datos completos o replicar el experimento? Escríbenos.